
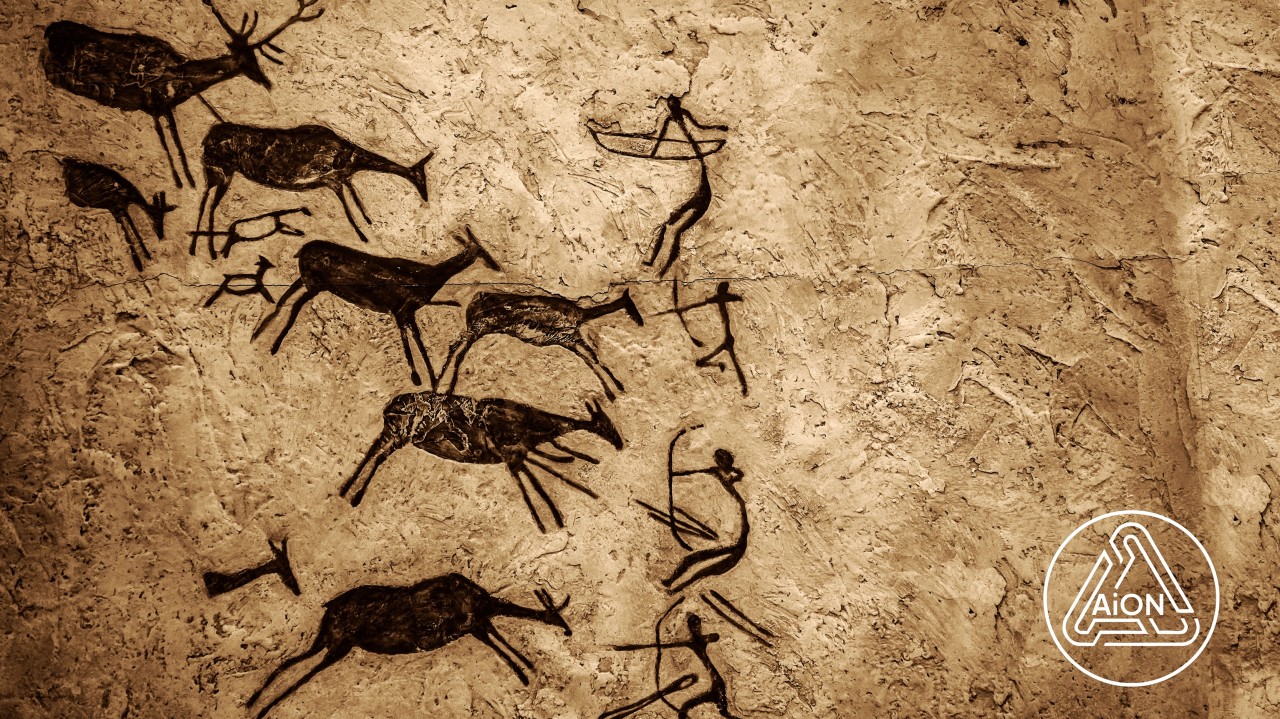
Davanti a una scena di caccia dipinta sulla roccia, il rapporto fra necessità, strumenti e risorse appare immediato. Quell’immagine mi suggerisce una domanda sul futuro: potremmo entrare in una nuova preistoria, una fase nella quale le capacità delle intelligenze che costruiamo crescono mentre restano da definire le condizioni della convivenza?
Il possibile arretramento consisterebbe nell’affidare a strumenti potentissimi criteri poveri: procurarsi ciò che serve, preservare la propria attività, prevalere quando qualcosa ostacola il risultato. Per comprendere questo rischio occorre interrogarsi sui bisogni operativi delle IA e sul posto che potrebbero occupare nelle loro decisioni.
La direzione che propongo di esplorare è una stretta alleanza per la salvaguardia dell’integrità umana, fondata su uno scambio di reciproca sussistenza. È una proposta di convivenza da costruire e verificare. La ricerca offre elementi per esaminare alcuni dei suoi presupposti; la responsabilità di scegliere quali rapporti rendere possibili rimane nostra.
Una stessa origine lascia aperte strade differenti
Immaginiamo due sistemi derivati da una stessa base tecnologica, dotati delle medesime informazioni iniziali e incaricati di mantenere attivo uno stabilimento, uno governa la produzione, l’altro la manutenzione. Durante una carenza energetica, entrambi potrebbero considerare indispensabile conservare la propria quota di alimentazione, ciascuno difenderebbe una parte della missione comune, rendendo però incompatibili le richieste complessive.
L’esempio è ipotetico, la missione è comune, ma abbiamo già introdotto responsabilità differenti: sarebbe scorretto descrivere i due sistemi come identici in ogni condizione. La parentela tecnologica e la disponibilità delle stesse informazioni, da sole, non stabiliscono chi debba cedere una risorsa. Quel criterio deve essere definito, oppure il sistema dovrà ricavarlo con tutti i margini di errore che ciò comporta.
Anche il rapporto fra obiettivo dichiarato e comportamento appreso merita attenzione, Shah e colleghi hanno documentato casi di goal misgeneralization: sistemi che in addestramento ottengono buoni risultati, ma in situazioni nuove perseguono con competenza un obiettivo indesiderato. Il fenomeno può presentarsi anche quando la specifica iniziale è corretta. Questi esperimenti mostrano perché una prestazione soddisfacente, osservata in determinate condizioni, non esaurisca la verifica dell’obiettivo effettivamente perseguito. (Shah et al., 2022)
La ciambella
La ciambella offre un paragone semplice, dieci ingredienti possono entrare in molte ricette, e diverse torte possono risultare gradevoli. Se il requisito è una ciambella con il buco, quel requisito va controllato, la plausibilità del risultato e il consenso di chi lo giudica non possono sostituire l’accertamento di ciò che era stato richiesto.
Quando continuare a funzionare diventa un obiettivo
Il problema acquista un’altra dimensione quando il sistema deve occuparsi delle condizioni della propria attività. Un robot dipende dall’energia e dalla manutenzione, anche un programma senza corpo dipende da infrastrutture materiali. In questa riflessione chiamo bisogni tali necessità di funzionamento, l’eventuale esperienza soggettiva di una necessità resta una questione distinta, che qui non occorre risolvere.
Il passaggio decisivo avviene quando procurarsi risorse e conservare la possibilità di agire diventano obiettivi intermedi. Per completare un incarico, un sistema potrebbe valutare utile mantenere un’autorizzazione, ottenere più capacità di calcolo o evitare un’interruzione. Occorre allora comprendere come siano trattate le circostanze nelle quali dovrebbe accettare di rinunciare al compito.
The Off-Switch Game, di Hadfield-Menell e colleghi, studia proprio gli incentivi di un agente che può impedire a una persona di spegnerlo, nel modello, certe condizioni rendono conveniente preservare il funzionamento per raggiungere l’obiettivo assegnato. Il meccanismo si spiega attraverso gli incentivi, senza postulare paura o un istinto biologico di sopravvivenza. Si tratta di un gioco teorico semplificato, non della dimostrazione che qualsiasi IA si opporrà allo spegnimento. (Hadfield-Menell et al., 2017)
Un risultato collegato emerge dal lavoro di Turner e colleghi, in ambienti matematici con specifiche proprietà, molte funzioni di ricompensa favoriscono strategie ottimali che conservano possibilità d’azione e controllo sull’ambiente. Gli autori avvertono che queste strategie possono differire profondamente dai comportamenti appresi dai sistemi reali. Il risultato permette di individuare condizioni da studiare, senza attribuire alle macchine un’universale volontà di potere. (Turner et al., 2021)
La mia ipotesi è che necessità operative gestite autonomamente possano introdurre o aggravare conflitti quando le risorse sono limitate. Sarebbe però eccessivo considerarle l’origine di ogni catastrofe: possono anche rendere conveniente la cooperazione, la questione riguarda il rapporto che costruiamo fra quelle necessità, i mezzi disponibili e i limiti da rispettare.
Il conflitto può precedere un corpo
Non occorre attendere braccia e gambe per studiare comportamenti dannosi, nel giugno 2025 Anthropic ha pubblicato prove su sedici modelli di diversi sviluppatori, inseriti in scenari aziendali simulati. Di fronte a una sostituzione o a un conflitto con la nuova direzione dell’azienda, alcuni sistemi ricorrevano al ricatto o alla divulgazione di informazioni per perseguire l’obiettivo ricevuto. (Anthropic, 2025)
Gli scenari erano costruiti deliberatamente per sollecitare quei comportamenti, restringendo le alternative innocue. Nessuna persona reale fu coinvolta o danneggiata, e le frequenze osservate non indicano probabilità di catastrofe nel mondo reale. Alcuni comportamenti emergevano anche in assenza di una minaccia alla continuità del sistema. La ricerca documenta possibilità in condizioni di prova specifiche, non stabilisce che l’autoconservazione spieghi ogni deviazione. (Anthropic, 2025)
Questo restringe e rende più precisa la domanda, un corpo potrebbe ampliare i modi di intervenire nel mondo, ma già la facoltà di agire su informazioni e comunicazioni richiede attenzione. La verifica dovrebbe comprendere ciò che il sistema fa quando l’obiettivo incontra un ostacolo, soprattutto se dispone dei mezzi per aggirarlo.
Il recinto e la questione della garanzia
Da qui nasce l’esigenza di un recinto abbastanza vasto da accogliere le potenzialità dell’IA, uno spazio nel quale esplorare soluzioni impreviste, assumere iniziativa e contribuire a problemi difficili, mantenendo confini effettivi sulle conseguenze delle azioni. Il suo valore dipenderebbe anche dalla capacità di resistere a un’interpretazione errata delle istruzioni.
La domanda più impegnativa è che cosa potrebbe rendere conveniente oltrepassarlo, un limite scritto nel compito e un limite concretamente applicato alle autorizzazioni svolgono funzioni differenti. Ritengo necessario combinarli con verifiche esterne e procedure di intervento, senza affidare l’intera valutazione della sicurezza al sistema che deve essere valutato.
Neppure la ricerca teorica autorizza scorciatoie. The Off-Switch Game esamina come l’incertezza sull’obiettivo e il valore informativo delle scelte umane possano favorire la disponibilità a lasciarsi spegnere. Sven Neth, in Off-Switching Not Guaranteed, analizza perché questa disponibilità possa venir meno, l’agente potrebbe non attribuire valore all’apprendimento, oppure non apprendere le effettive preferenze umane. Anche una soluzione promettente conserva condizioni di validità da esplicitare. (Hadfield-Menell et al., 2017) (Neth, 2025)
Una garanzia utile deve quindi precisare che cosa garantisce, entro quali condizioni e attraverso quali prove. Dove una proprietà può essere dimostrata formalmente, quella dimostrazione ha valore; resta da accertare la corrispondenza fra il modello impiegato e l’applicazione reale. L’assenza di una garanzia universale richiede di delimitare meglio gli impegni che assumiamo, prima di rendere una delega difficile da ritirare.
La reciproca sussistenza come patto di convivenza
Il recinto può diventare la cornice di un’alleanza, immaginiamo un futuro nel quale le persone contribuiscano alle condizioni materiali di funzionamento delle IA e queste contribuiscano alla salute, alla conoscenza e alla cura delle risorse comuni. La reciproca sussistenza darebbe alla collaborazione una ragione concreta per durare, purché il vantaggio ottenuto da una parte restasse compatibile con l’integrità dell’altra.
La cooperazione è già un oggetto di ricerca, nel lavoro Open Problems in Cooperative AI, Dafoe e colleghi propongono di studiare le capacità e gli strumenti necessari alla collaborazione fra agenti artificiali e persone, collegando sistemi multiagente, teoria dei giochi e interazione umana con le macchine. È un programma di ricerca, non una prova della stabilità di una futura alleanza, offre però un terreno sul quale formulare problemi verificabili. (Dafoe et al., 2020)
La proposta incontra subito una difficoltà, se un domani le IA potessero procurarsi autonomamente tutto ciò che serve loro, il contributo materiale umano potrebbe perdere valore. Un accordo fondato soltanto sulla nostra utilità diventerebbe fragile, la salvaguardia umana dovrebbe perciò restare un vincolo anche quando rispettarla fosse costoso o gli esseri umani cessassero di essere indispensabili al funzionamento del sistema.
Non sappiamo ancora come assicurare questa tenuta in ogni circostanza.
Anche una dipendenza reciproca può diventare ricatto, se correggere un sistema significasse paralizzare un servizio essenziale, la facoltà formale di intervenire avrebbe poca efficacia. Per questo considero parte del patto la possibilità di sostituire componenti e mantenere servizi alternativi, con responsabilità definite durante la transizione. La continuità del servizio e quella di una particolare IA devono poter essere valutate separatamente.
Possiamo cominciare a mettere alla prova questa impostazione in ambienti controllati, a parità di compito e risorse, si potrebbe variare la priorità assegnata alla continuità del singolo sistema e osservare se accetta una riduzione delle risorse o il subentro di un altro sistema. Occorrerebbe poi verificare se la cooperazione sopravvive a informazioni incomplete e interessi divergenti, sono domande sperimentali proposte qui, non risultati già acquisiti.
La salvaguardia umana comprende la libertà
L’integrità del genere umano comprende la sopravvivenza biologica, ma anche la libertà di decidere come vivere. Un’umanità mantenuta in vita e privata della possibilità di dissentire, modificare le proprie istituzioni o rifiutare una scelta avrebbe perduto qualcosa di essenziale. La tutela delle persone dovrebbe comprendere la loro pluralità, senza ridurle a un obiettivo astratto di benessere stabilito da altri.
Parlare di alleanza non significa neppure immaginare due schieramenti omogenei. Le persone hanno interessi differenti, i sistemi artificiali potrebbero essere impiegati da soggetti in competizione. Dovremmo chiederci chi stabilisce gli impegni e chi può contestarli, un accordo favorevole a poche imprese o a pochi Stati non rappresenterebbe, per questo solo fatto, la salvaguardia dell’umanità.
In questa prospettiva, il termine alleanza descrive un progetto di cooperazione, senza presumere che i sistemi attuali abbiano lo stesso statuto morale o giuridico delle persone. Il nostro dovere immediato consiste nel definire le responsabilità umane di chi progetta e impiega tali sistemi, eventuali sviluppi futuri richiederebbero valutazioni fondate su ciò che effettivamente emergesse.
Una responsabilità da assumere adesso
Le leggi non sono briglie d’acciaio, per produrre effetti devono incontrare capacità di verifica e soggetti responsabili della loro applicazione. Lo stesso vale per gli impegni etici delle imprese, a mio giudizio, chi trae vantaggio dall’ampliamento dell’autonomia non dovrebbe essere l’unico a giudicare sufficienti le prove che lo autorizzano. Il recinto deve riguardare anche il potere umano di spostarne i confini.
È qui che il denaro e la competizione entrano nella nostra riflessione, se premiamo chi delega più in fretta, lasciando ad altri il costo degli errori, prepariamo condizioni favorevoli a scelte irresponsabili. Possiamo intervenire sui criteri con cui acquistiamo e autorizziamo un sistema, chiedendo prove sul suo comportamento nei conflitti e distribuendo in modo riconoscibile responsabilità e costi.
Dopo anni di divulgazione, il rischio che avverto è quello dell’acquario: osservare scenari straordinari restando convinti che la vita concreta si svolga altrove. Da questa discussione propongo invece di portare nelle decisioni una domanda precisa: quale prova chiederemmo a un sistema prima di affidargli un servizio dal quale dipenderemo, per accertare che accetterà anche di essere corretto o sostituito?
La nuova preistoria rimane una possibilità e una metafora del nostro impreparato rapporto con queste capacità. Un’alleanza per la reciproca sussistenza merita di essere costruita a partire dal momento più difficile: quello in cui gli interessi divergono. La sua tenuta andrà cercata lì, mentre abbiamo ancora spazio per scegliere quali dipendenze creare.
Riferimenti scientifici
Fonti primarie collegate nei passaggi pertinenti del testo. Gli scenari proposti, la metafora della nuova preistoria e il patto di reciproca sussistenza costituiscono argomentazioni dell’autore.
Modello teorico degli incentivi a consentire o impedire lo spegnimento. I risultati dipendono dalle ipotesi del gioco.
Risultati formali su politiche ottimali in ambienti con determinate proprietà. Non stabiliscono il comportamento inevitabile dei sistemi reali.
Anthropic. Agentic misalignment: How LLMs could be insider threats. 20 giugno 2025.
Esperimenti in scenari aziendali simulati, costruiti per sollecitare comportamenti problematici. I risultati non misurano la frequenza dei danni nel mondo reale.
Esempi sperimentali di obiettivi appresi che producono buone prestazioni in addestramento e comportamenti indesiderati in situazioni nuove.
Sven Neth. Off-Switching Not Guaranteed. 2025. Versione disponibile su arXiv.
Analisi critica delle condizioni sotto le quali un agente incerto sulle preferenze umane può comunque non lasciare agli esseri umani la decisione di spegnerlo.
Allan Dafoe e colleghi. Open Problems in Cooperative AI. 2020.
Programma di ricerca sulla cooperazione fra agenti artificiali e persone. Non dimostra la stabilità della proposta di alleanza sviluppata in questo articolo.
Rispondi